Ce este un NPU și când contează pentru AI pe laptop sau telefon
Ce este un NPU și când contează pentru AI pe laptop sau telefon
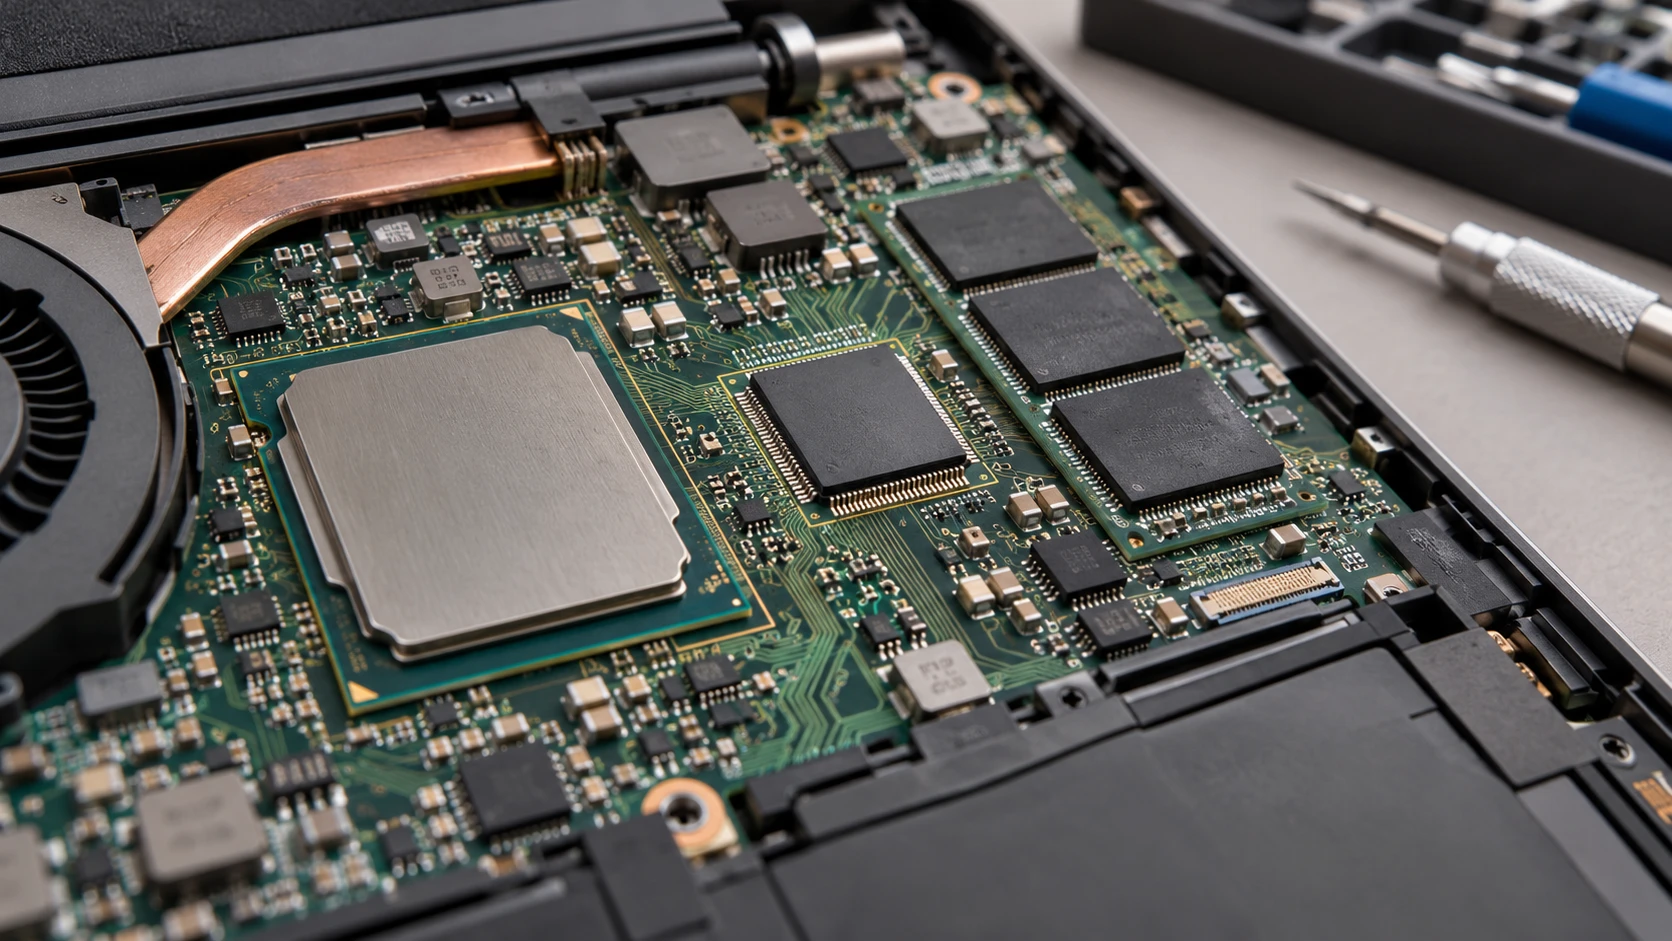
Un NPU (Neural Processing Unit) este un circuit proiectat pentru operațiile matematice repetitive folosite de rețelele neuronale. El poate executa inferențe AI cu un consum mai mic decât un CPU generalist și poate elibera GPU-ul pentru grafică. Prezența lui nu înseamnă însă că laptopul poate rula orice model generativ și nici că datele rămân automat private.
Ce calcule face un NPU
Modelele de învățare automată folosesc masiv înmulțiri și adunări pe matrice și tensori. Un CPU poate face aceste operații, dar este construit pentru o varietate mare de sarcini și pentru control complex. GPU-ul are multe unități paralele și este eficient la calcule ample, însă poate consuma mai multă energie.
NPU-ul include blocuri optimizate pentru inferență: etapa în care un model deja antrenat primește o imagine, un sunet sau un text și produce un rezultat. Arm descrie NPU-ul ca accelerator care preia de la CPU operațiile intensive pe matrice și tensori. Într-un telefon, acest lucru permite procesarea continuă a camerei sau a sunetului fără descărcarea rapidă a bateriei.
Antrenarea modelelor mari rămâne, de regulă, o sarcină pentru GPU-uri sau acceleratoare din centre de date. Unele ajustări mici pot rula local, dar termenul NPU nu spune singur ce tip de antrenare este posibil.
Unde îl întâlnești
Telefoanele folosesc de ani buni acceleratoare neuronale pentru fotografie computațională, recunoașterea vorbirii, estomparea fundalului, traducere și clasificarea imaginilor. În laptopuri, NPU-urile au devenit vizibile odată cu funcțiile AI care trebuie să ruleze repetat și eficient energetic.
Microsoft definește pentru categoria Copilot+ PC un prag de cel puțin 40 TOPS pentru NPU. TOPS înseamnă trilioane de operații pe secundă, dar nu este un test universal de viteză. Producătorii pot număra operații și precizii numerice diferite, iar performanța depinde de memorie, compilator, formatul modelului și software.
Un NPU de 40 TOPS poate fi mai lent decât un GPU la un model mare, dar mai potrivit pentru o cameră care aplică efecte în timp real ore întregi. Cifra trebuie citită împreună cu aplicațiile compatibile.
Ce înseamnă AI „pe dispozitiv”
Procesarea locală poate reduce latența și poate funcționa fără internet. Dacă aplicația păstrează intrarea și rezultatul pe dispozitiv, există și un avantaj de confidențialitate: fotografia sau înregistrarea nu trebuie trimisă unui server.
Acest avantaj nu este automat. O aplicație poate folosi NPU-ul pentru o etapă și cloudul pentru alta, poate sincroniza rezultatele sau poate colecta telemetrie. Politica aplicației și indicatorii din sistem sunt mai importanți decât eticheta „AI PC”.
Microsoft arată că aplicațiile pot folosi strategii de rezervă: NPU pe hardware compatibil, GPU sau CPU pe alte sisteme și servicii cloud când modelul local nu este suficient. Din perspectiva utilizatorului, aceeași funcție poate avea comportamente diferite pe două calculatoare.
Când contează la cumpărare
NPU-ul contează dacă aplicațiile folosite au suport real pentru el: efecte video în conferințe, subtitrări, transcriere, procesare foto, modele locale mici sau instrumente de accesibilitate. Pentru navigare web, documente și streaming, diferența poate fi greu de observat.
Verifică patru lucruri: lista de funcții accelerate, cerințele versiunii de sistem, memoria RAM disponibilă și consumul măsurat în teste independente. Nu cumpăra doar după TOPS. Un model local are nevoie și de memorie; dacă aceasta este insuficientă, acceleratorul nu rezolvă problema.
Pentru jocuri și randare 3D, GPU-ul rămâne componenta principală. Pentru compilare și sarcini generale, arhitectura și performanța CPU contează mai mult. NPU-ul este o unitate complementară.
Limitările actuale
Compatibilitatea este fragmentată între platforme și generații de cipuri. Un model trebuie convertit și optimizat pentru operatorii acceptați. Dacă o operație nu este suportată, o parte din calcul revine pe CPU sau GPU, iar avantajul scade.
Modelele generative pot produce erori indiferent unde rulează. Execuția locală nu îmbunătățește automat acuratețea, nu elimină biasul și nu transformă un răspuns probabilistic într-un fapt verificat.
Cum compari două dispozitive
Pornește de la funcția pe care vrei să o folosești, nu de la numele acceleratorului. Verifică dacă aplicația menționează explicit generația de cip, sistemul de operare și memoria minimă. Un benchmark care rulează un model de viziune mic nu prezice viteza unui asistent lingvistic cu miliarde de parametri.
Uită-te separat la latență, consum și performanță susținută. O demonstrație de câteva secunde poate folosi o putere mare fără să arate încălzirea sau autonomia. Pentru videoconferințe și transcriere continuă, eficiența pe termen lung este mai relevantă decât un vârf TOPS. Pentru modele mari folosite ocazional, capacitatea GPU și cantitatea de memorie pot cântări mai mult.
Întrebări frecvente
NPU și GPU sunt același lucru?
Nu. Ambele pot accelera AI, dar GPU-ul este mai general și orientat și spre grafică, iar NPU-ul urmărește eficiența pentru operatori neuronali.
Pot adăuga un NPU ulterior?
De obicei nu ca pe memoria RAM. Există acceleratoare externe pentru proiecte speciale, dar NPU-ul de consum este integrat în procesor sau sistemul pe cip.
Un laptop fără NPU nu poate rula AI local?
Poate. CPU-ul și GPU-ul pot rula modele locale; diferențele apar la eficiență, viteză și funcțiile acceptate.
Transparență AI: acest conținut poate fi redactat sau structurat cu ajutorul unor instrumente AI și este verificat editorial înainte de publicare. Imaginile generate sau modificate cu AI sunt folosite cu rol ilustrativ.